
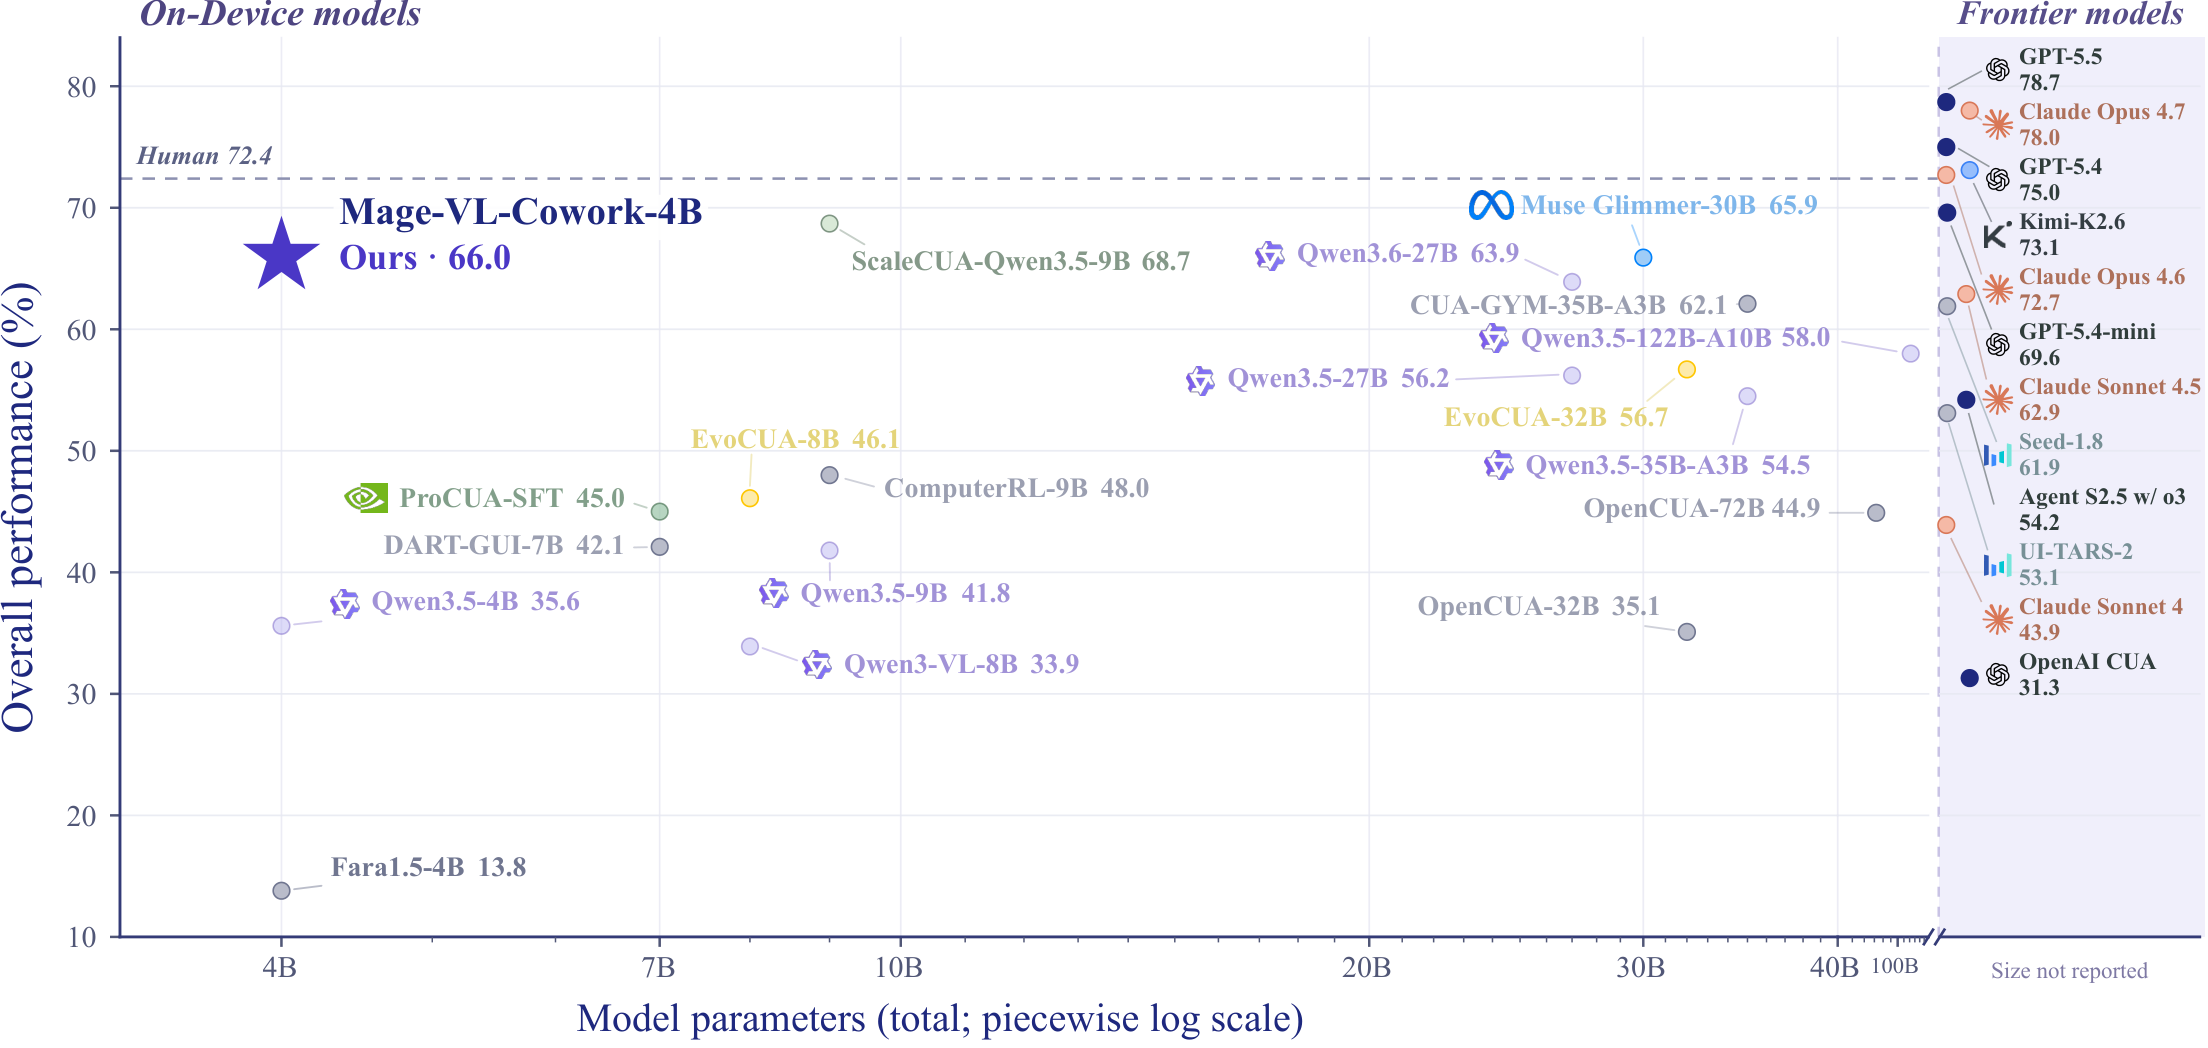
El viernes 30 de octubre, el equipo Mage de Microsoft subió a Hugging Face un checkpoint de 4B llamado Mage-VL-Cowork. No es otro modelo multimodal genérico: es un agente de uso de computadora que, en un solo policy, elige en cada turno si manipular la interfaz gráfica o ejecutar código en una terminal persistente. El anuncio trae página de proyecto, informe técnico y harness para OSWorld. El número de portada es 66.0% en OSWorld-Verified. Detrás hay una tesis más interesante que el ranking: la calidad del harness del profesor importa más que el tamaño del alumno, y combinar GUI con shell no se aprende solo distilando un frontier sin limpiar las herramientas.
Qué pasó
Mage-VL-Cowork es un agente híbrido de computer use con arquitectura llava_onevision2. El backbone combina un encoder visual Mage-ViT (parches 16×16, spatial_merge_size=2, 3D RoPE) con Qwen3-4B (Qwen3-4B-Instruct-2507). El checkpoint pesa 9.48 GB en bfloat16, en dos shards safetensors. La ventana activa es de 32,768 tokens; la arquitectura admite hasta 262,144. La memoria de trabajo es asimétrica: conserva las tres capturas más recientes y cuatro respuestas completas, y comprime el historial anterior en resúmenes imperativos de una línea con el prefijo Action:.
Los canales son dos. computer_use expone once primitivas GUI (click, double_click, triple_click, move, drag, type, keypress, scroll, wait, screenshot, terminate) con coordenadas normalizadas en [0, 999]. bash ejecuta shell y Python en un entorno persistente bajo /tmp_workspace y devuelve texto, no otra captura. No hay orquestador externo: la política elige el canal en cada turno. Cada paso sale en tres partes: <think>, una línea Action: y uno o más <tool_call>.
La evaluación principal usa 361 tareas de OSWorld-Verified (sin Google Drive), presupuesto de 50 pasos, escritorio 1920×1080 e historial history_n=3. El 66.0% es el promedio de dos corridas: 65.33% y 66.75%. Por categorías: 87.5% en sistema operativo, 64.9% en Office, 65.0% en Daily, 66.3% en Professional y 62.7% en Multi-Application Workflows. A escala 4B es el mejor resultado de esa tabla; por encima quedan ScaleCUA-Qwen3.5-9B (68.7%) y varios frontier, y por debajo Muse Glimmer-30B (65.9%) y Qwen3.6-27B (63.9%). Fara1.5-4B, especialista de navegador de la misma escala, se queda en 13.9% en el escritorio completo.
El entrenamiento es un currículo de cinco etapas specialize-then-unify. Parte de un checkpoint intermedio de Mage-VL y avanza por midtraining GUI, SFT de agente GUI, SFT de coding y terminal, SFT híbrido y RL híbrido en línea con GRPO asíncrono y recompensas verificables. Del SFT de GUI al RL final sube de 45.56% a 66.0% (+20.44 puntos). El salto del SFT híbrido al RL es de +10.16 puntos, con menos llamadas medias al modelo (21.57 a 18.77, −13.0%) y menos tokens de salida (7,374 a 5,499, −25.4%).
Antes del corpus a gran escala, el equipo evolucionó el harness del profesor: poda rutas redundantes (por ejemplo xdotool y dumps de accesibilidad), preinstala bibliotecas de dominio (python-pptx, openpyxl, pandas, pypdf, pillow) y define harnesses de GUI, terminal e híbrido. En 672 tareas multiaplicación, el harness GUI + coding alcanza 92.0% del profesor con 25.00 pasos de media; con accesibilidad añadida baja a 89.6% y sube a 35.33 pasos. El alumno de 4B hereda la diferencia: 37.6% frente a 25.1% (+12.5 puntos) y trayectorias 21.5% más cortas.
La generación de datos corre a cargo de Mage-CUA-Forge. En lugar de construir cada tarea con un bucle abierto, se autoran flujos reutilizables por habilidad atómica. Resultado reportado: 293,806 tareas distintas, 6,915 habilidades, 38.24% multiaplicación, 877,608 referencias a archivos en 278 categorías y 318,837 trayectorias híbridas retenidas (68.19% GUI, 31.81% terminal). El costo recurrente por tarea cae de 1,276K tokens y 0.906 dólares a 85K tokens y 0.158 dólares (−93.3% tokens, −82.6% gasto), con el mismo generador (gpt-5.6-terra).
En transferencia a navegador, el checkpoint de SFT (antes del RL) alcanza 58.6% en WebVoyager-Static: 643 tareas sobre réplicas locales con verificación de traza de UI y estado backend en SQLite. Queda detrás de Fara1.5-4B (68.0%) y por delante de varios VLM generales de 4B a 9B. En demos en tiempo real frente a Qwen3.6-27B solo-GUI, el híbrido de 4B termina una edición de LibreOffice Calc en 39 segundos y 6 pasos frente a 9:56 y 39 pasos.
La licencia es Apache-2.0. Hay página de proyecto, repositorio microsoft/Mage y un paquete osworld_eval/ con el agente híbrido y un lanzador Docker de SGLang. La ficha insiste: el modelo puede ejecutar comandos arbitrarios y debe correr en contenedores o VMs desechables, sin montar credenciales personales y con allow-list de red ante contenido no confiable.
Por qué importa
Primero, por la escala. El discurso de computer use se concentró en frontier caros o en especialistas de un canal. Un 4B open-weight que se acerque a GPT-5.4-mini en turnos (18.77 frente a 18.24) y consuma 55.6% menos tokens de salida abre la puerta a agentes en hardware local y edge. No es paridad con Claude Opus 4.7 ni con GPT-5.5: el argumento es que un VLM compacto puede dominar computer use complejo si la supervisión y el harness están bien diseñados.
Segundo, por la tesis del harness. El experimento de accesibilidad incomoda a quien asume que más herramientas equivalen a mejor agente. Un canal redundante que un frontier absorbe con pasos extra se convierte, en un alumno de 4B, en una pérdida de 12.5 puntos. Limpiar la interfaz del profesor antes de grabar trayectorias no es un detalle de MLOps: es parte del método.
Tercero, por el canal terminal. Los agentes que solo ven píxeles pagan un impuesto alto: cada captura consume miles de tokens y reeditar un Excel a clics descarta la vía más verificable de la máquina. Mage-VL-Cowork internaliza el cambio de canal. En las demos abre openpyxl en bash para fusionar celdas; en GIMP mezcla edición visual con verificación de dimensiones y canal alfa desde la terminal.
Cuarto, por la evaluación. OSWorld-Verified y WebVoyager-Static con estado backend responden a la inflación de scores en demos vivas y jueces VLM basados solo en captura. Microsoft documenta deltas de 12.8 a 33.1 puntos entre live y static en agentes web publicados. Quien compare productos debería pedir el protocolo, no solo el porcentaje.
El detalle técnico (que no se está discutiendo)
Los titulares se quedan en “4B al 66%”. Hay matices que cualquier equipo de seguridad o de plataforma debería leer antes de enchufar el modelo a un escritorio real.
- Los números son auto-reportados. Los resultados de OSWorld son de Microsoft con su harness
MAGEHybridAgenty, al momento del anuncio, no están verificados de forma independiente. El promedio de dos corridas mejora el protocolo; no sustituye a una evaluación de terceros.
- El system prompt es parte del producto. El modelo se entrenó contra un contrato de dos canales y un formato estricto. La ficha publica el prompt y advierte que usarlo tal cual da el mejor rendimiento. Cambiar el scaffolding o el esquema de tool calls es salir de la distribución de entrenamiento.
- La memoria visual es corta a propósito. Solo tres capturas activas. Eso favorece políticas concisas después del RL y también implica que un fallo cuatro pasos atrás puede quedar fuera de la ventana visual. El harness de producción debe decidir qué estado persiste fuera del contexto del modelo.
- Bash sin sandbox no es un demo, es un incidente. Responsible AI es explícita: aislamiento obligatorio, confirmación humana antes de acciones irreversibles, cero exposición de credenciales y allow-list de red contra inyección indirecta. Un agente con
bashycomputer_useen la misma sesión es una superficie de ejecución arbitraria. Publicarlo en Apache-2.0 no reduce ese riesgo; solo lo documenta.
- Híbrido no significa generalista ilimitado. En WebVoyager-Static el SFT queda detrás de un especialista de navegador. En OSWorld, ScaleCUA-Qwen3.5-9B sigue por delante. La promesa real no es “el mejor agente del mundo”, sino que un currículo specialize-then-unify más un harness evolucionado puede empujar la frontera on-device.
Hay un punto operativo más: 7.79 ZFLOPs nominales en cinco etapas, con 32 NVIDIA B200 y 1,120 slots de sandbox de CPU para RL. Reproducir el currículo completo no es trivial; reproducir la inferencia y el harness sí, y ahí está el valor inmediato.
Qué hacer
- Lee la ficha y el informe antes del demo reel. Los porcentajes por categoría —sobre todo OS 87.5% y Workflow 62.7%— dicen más que el overall sobre qué cargas probar primero.
- Reproduce OSWorld con
osworld_eval/. Contenedor SGLang documentado,max_steps=50,history_n=3y eltest_nogdrive.jsonde 361 tareas. Si tu score diverge, documenta el harness.
- No lo conectes a un escritorio de producción. VM o contenedor sin credenciales, sin cookies de sesión y con red restringida. Trata cualquier salida de
bashcomo código no confiable hasta que haya un humano en el loop.
- Diseña el harness, no solo el prompt. Si distilas a partir de un profesor frontier, mide el efecto de podar herramientas redundantes. El delta de +12.5 puntos en el alumno de 4B es la lección más transferible.
- Separa computer use de grounding y de entrenamiento. Este modelo ejecuta. No resuelve por sí solo las preferencias de robots.txt ni los controles de grounding. Son capas distintas.
- Mide tokens y pasos, no solo éxito. El RL mejora accuracy y reduce costo por tarea. Si tu agente “funciona” pero dispara 40 capturas para editar un CSV, estás pagando el impuesto que este paper intenta eliminar.
Fuentes
- microsoft/Mage-VL-Cowork (model card en Hugging Face)
- Página de proyecto Mage-VL-Cowork (Microsoft Mage)
- Repositorio de evaluación y código (microsoft/Mage, mage_vl_cowork)
#ia #agentes #computer-use #microsoft #osworld #modelos-abiertos
El dato duro no es que un 4B haya cruzado el 66%. Es que Microsoft tuvo que evolucionar el harness del profesor, sintetizar casi 300 mil tareas y pasar por cinco etapas para que ese 4B aprendiera cuándo dejar de hacer clic. Vale la pena preguntarse, con el mismo rigor, cuántos de los agentes que hoy conectamos a un escritorio real recibieron ese nivel de cuidado antes del primer bash.